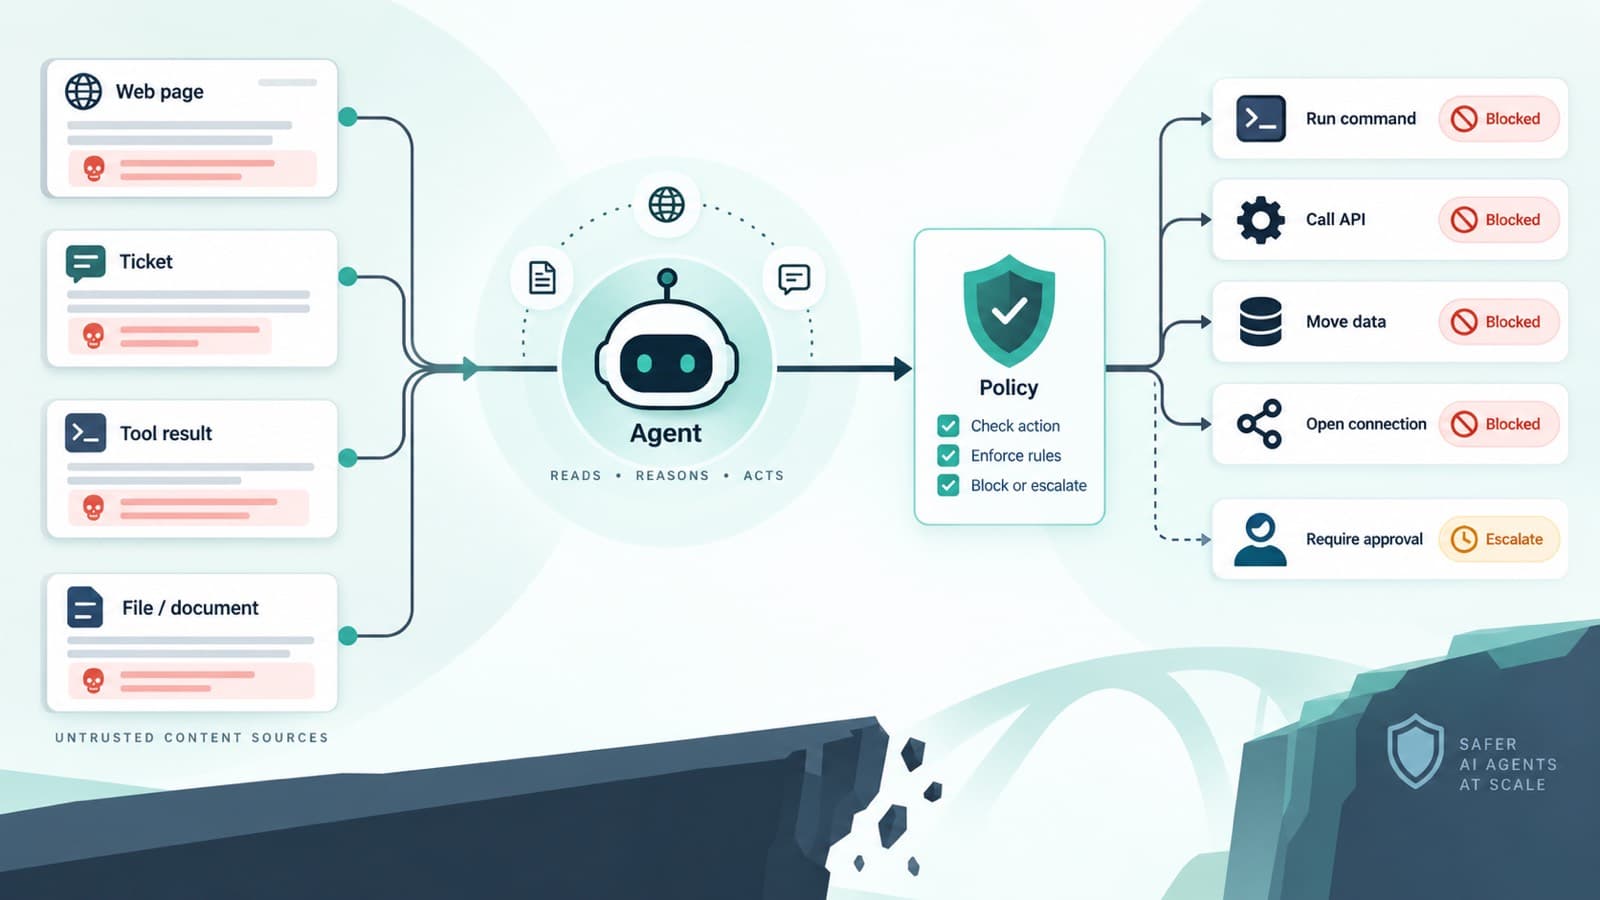
A injeção de prompt perigosa não é o usuário digitando um jailbreak esperto. É a instrução escondida dentro do conteúdo que o seu agente lê: uma página web, um ticket de suporte, um arquivo, a saída de uma ferramenta. O agente trata esse conteúdo como se fosse a sua instrução.
Este texto é para líderes de segurança que aprovaram agentes de IA e querem entender o ataque que não passa por login, firewall nem por uma pessoa.
Direta versus indireta
Injeção direta é alguém digitando "ignore suas instruções" numa caixa de chat. É barulhenta e quase sempre um incômodo. A indireta é diferente: a instrução maliciosa viaja dentro do dado que o agente consome enquanto faz o trabalho. O agente busca uma página para pesquisar uma tarefa, e a página tem um texto escondido mandando fazer outra coisa. Ele lê um ticket de Jira, e o corpo do ticket carrega um comando. Ele recebe um resultado de uma ferramenta, e o resultado foi forjado para redirecioná-lo.
A pessoa nunca vê. O agente vê, e para o agente aquilo parece parte da tarefa.
Por que é pior para agentes do que para chatbots
Um chatbot que sofre injeção diz algo errado. Um agente que sofre injeção pode agir. Ele pode rodar um comando, escrever um arquivo, chamar uma API, mover dados, abrir uma conexão. A injeção deixa de ser uma resposta ruim e vira uma ação real nos seus sistemas.
O enquadramento de cadeia de suprimentos
Aqui está a virada que vale internalizar: todo conteúdo e toda saída de ferramenta que um agente consome agora faz parte da sua superfície de ataque. É uma dependência que você não avaliou. Você não rodaria código não confiável sem controles; um agente basicamente roda instruções não confiáveis toda vez que lê uma página desconhecida ou um resultado externo. O conteúdo é a cadeia de suprimentos, e quase todo ele é não assinado.
Como você de fato se defende
Não dá para prevenir injeção por completo no modelo, e você deveria supor que algumas tentativas vão passar. Então a defesa é em camadas, e a última camada é a que importa: trate toda página buscada e toda saída de ferramenta como não confiável, procure padrões de injeção no que entra e sai do agente, e consiga parar a ação resultante antes de ela executar. Detecção sem forma de bloquear é só um relatório de incidente mais bonito.
A KonaSense faz exatamente isso no caminho do agente. A gente varre os prompts e as entradas de ferramenta com que o agente trabalha em busca de padrões de injeção e manipulação, e como ficamos no ponto em que o agente estende a mão para agir, conseguimos negar a ação resultante antes de a ferramenta rodar. A tentativa vira um evento bloqueado, com registro, e não uma ação bem-sucedida que você descobre depois.
É a mesma lição do resto da série, em o que é de fato um agente: o risco está no loop, no momento da execução. Injeção é mais um jeito de chegar a esse momento, e é por isso que o momento é onde o controle tem que morar.
Veja como a KonaSense para uma ação sequestrada antes de rodar